JavaScript 为什么有时能接近 Wasm?一次 V8 性能实验
为什么 JavaScript 的热点循环有时能接近 Rust 编译的 Wasm?从同算法实测出发,逐步理解预热、类型反馈、对象形状与去优化。
假设你有一个计算热点:遍历一批数值,做完累加,再把结果交给页面。JavaScript 版本已经跑通,但你想再快一点,于是考虑把它改写成 Rust,编译为 WebAssembly。
直觉上,这应该是一次很有把握的优化:一边是动态类型的 JavaScript,一边是静态类型、经过编译器优化的 Rust。然而,如果测到两者只差一点,甚至几乎一样快,该怎样解释?是 Wasm 没有发挥出来,还是我们低估了 JavaScript?
这个问题值得拆开看。“JavaScript JIT 有时能接近 Rust → Wasm”可以是一个待验证的现象,不能直接当作所有现代浏览器、所有程序的结论。 我们先让两种实现完成同一件小事,再逐步改变执行方式和数据结构,看差距在哪里出现。
下文的实测环境是 Node.js 中的 V8,目的是隔离计算内核。它与 Chrome 的引擎技术有关,但不等于已经测过 Chrome、Safari、Firefox 的真实页面;也不等于 Rust 原生可执行程序的性能。
本次实验环境
本文各组实验的计时在 2026 年 10 月 28 日于同一台机器完成:
| 项目 | 本次配置 |
|---|---|
| 硬件 | Apple M1 Pro,arm64 |
| 系统 | macOS,Darwin 25.6.0 |
| 运行时 | Node.js v24.22.1 |
| 引擎 | V8 13.6.233.17-node.58 |
| 数据量 | 32,768 个对象或数值 |
| 每批工作 | 完整遍历 32 次,共 1,048,576 次访问并求和 |
| 预热 | 首批执行后,再运行 20 批 |
| 采样 | 每个配置启动 5 个独立进程,每个进程测 15 批 |
| 汇总 | 先取每个进程的中位数,再取这 5 个中位数的中位数 |
数据在计时前构造。所有案例使用 (i % 100) + 0.25 这组可精确表示的值,每批结束后在计时之外断言求和结果正确,避免把不同工作混在一起比较。
案例串行执行,每轮轮换顺序;不同案例不共享进程,减少类型反馈相互污染。计时阶段不开优化日志,也不强制优化或手动 GC。原始样本全部保留,没有剔除“看起来不好看”的数据。
图中的点是 5 个进程各自的中位数,线是它们的最小值到最大值,不是置信区间,也不是单次调用的尾延迟。预热不保证每次运行都处于完全相同的编译层级;系统调度、CPU 状态与后台任务仍可能影响结果。
Rust 对照使用 rustc 1.98.0(88d9e12ae,2026-08-18)、wasm32-unknown-unknown 目标、opt-level=3 和 panic=abort。不调用 wasm-bindgen,不额外运行 wasm-opt,也不加入手写 SIMD。源码、编译参数和二进制 SHA-256 与结果一起保留。安装与编译目标的说明见 Rust 官方目标文档。
第一步:让 JavaScript 和 Rust → Wasm 做同一件事
先把场景收窄到一个容易核对的内核:32,768 个双精度数值,按顺序遍历 32 轮,返回累加结果。JS 用 Float64Array;Rust 从 Wasm 线性内存中的固定缓冲区读取 f64。两边输入完全一致。
JavaScript 的完整计算循环是:
function sum(data, passes) {
  let total = 0;
  for (let p = 0; p < passes; p++) {
    for (let i = 0; i < data.length; i++) total += data[i];
  }
  return total;
}
Rust 的对应计算部分如下;完整源码另有向宿主暴露缓冲区地址的接口:
// data 是宿主已经写入的 f64 切片,passes 在本次实验中为 32。
let mut total = 0.0;
for _ in 0..passes {
    for &value in data {
        total += value;
    }
}
先测数据已经就绪的计算,再增加一个变体:每批先将 256 KiB 输入复制进 Wasm 内存,随后求和。每批只跨越 JS / Wasm 边界调用一次,不能把它误读成每个元素都跨边界。
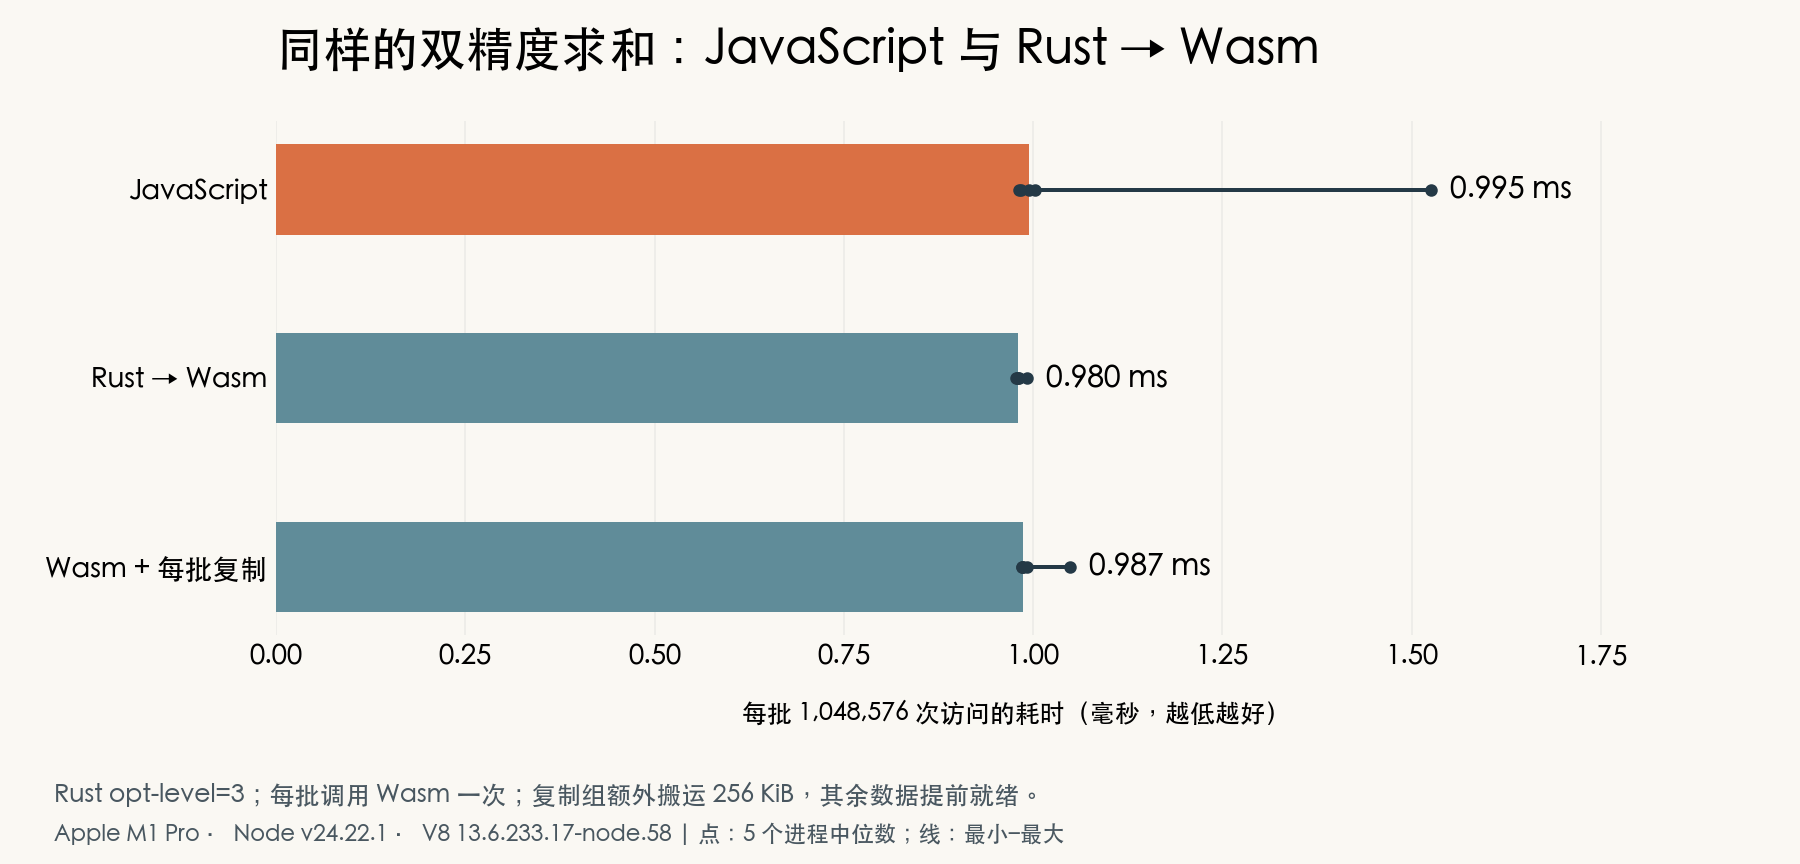
| 实现 | 每批耗时 | 5 个进程中位数范围 |
|---|---|---|
| JavaScript | 0.995 ms | 0.981–1.526 ms |
| Rust → Wasm,数据预先就绪 | 0.980 ms | 0.978–0.992 ms |
| Rust → Wasm,每批复制再求和 | 0.987 ms | 0.985–1.049 ms |
现在才有了第一条实测结论:在这个预热后的求和内核里,两者的汇总值只差约 1.6%。 这不足以宣称某一方稳定更快,却说明“动态语言与静态语言之间必然存在巨大性能鸿沟”的直觉,在这里没有得到支持。
还要留意分布:JS 有一个进程的中位数达到 1.526 ms,明显偏离另外四个进程;原始结果和图中都保留了它。本文没有采集能定位这次波动原因的剖面,所以不把它武断归因于 JIT 或去优化,也不能因为总中位数接近就说稳定性已经相同。
复制组也没有显示出很大的额外差距。本例每批只复制一次 256 KiB,随后遍历 32 次,复制成本占总耗时的比例可能较小。不过,这组对照没有单独测量复制成本,复制也可能影响后续读取的缓存状态,因此不能直接把两组汇总值之差当作复制耗时。如果业务每搬一次数据只计算一点点,需要重新设计对照。
接下来从编译机制出发,讨论两条执行路径的耗时为什么可能接近。
为什么两条执行路径可能靠近
我们平时用“解释型语言”和“编译型语言”区分 JS 与 Rust,但这不足以描述它们在同一个运行时中的最终状态。
JavaScript → 字节码 / 类型反馈 → 优化机器码
Rust → LLVM 优化 → Wasm → 引擎编译 → 机器码
Wasm 是一种中间格式,不是直接给当前 CPU 执行的原生指令。V8 会编译它,也有基线编译和热点优化的分层过程。因此,不能把这次对照理解成“JS 在解释,Rust 已经是机器码”。见 V8 的 WebAssembly 编译管线。
JavaScript 源码不会在每次循环时重新解析。以 V8 为例,源码会生成字节码,由 Ignition 解释执行;引擎再根据执行情况选择编译层级。Sparkplug 偏重快速生成机器码,Maglev 在编译成本和优化收益之间取中间位置,更高层的优化编译器继续处理值得投入的热点。
可以把它理解为“先启动,再按需要投入编译成本”。这不是所有函数必须依次经过的固定流水线,实际策略取决于版本和配置。本文机器的独立诊断日志中可以看到 MAGLEV 和 TURBOFAN_JS 编译记录。架构背景见 V8 的 Maglev 介绍。
运行反馈的价值在于缩小问题:某个加法位置通常遇到什么值?某处属性读取通常接收什么对象?哪些调用目标值得内联?引擎可以据此生成更专门的代码,但必须保留保证 JavaScript 语义正确的检查或依赖。
因此,“过去都是数字,所以以后彻底不检查”并不准确。检查可能被合并、移动或通过分析消除;一旦优化依赖的假设不成立,引擎仍然需要正确处理新的输入。
再看本例,循环没有显式创建新对象,也不涉及字符串拼接;主要操作是读取 Float64Array 的长度、按索引读取数值并累加。这些访问有机会被优化为专门的数值读取路径。Rust 在编译时已经知道数值类型;JS 则有机会通过容器和反馈把热点路径收窄为数值运算。两边最终可能都在做相似的加载、浮点加法和循环控制。
这解释了性能接近为什么合理,却不是两边机器码相同的证明。本文未做反汇编比较;单累加器还引入前后依赖,每次加法都需要前一次结果,这种内核并不能展示 Rust/Wasm 在所有算法上的优化空间。
第二步:从首次调用到预热后,分别观察
第一张图只回答“预热之后跑多快”。如果第一次调用也算进去,情况是否相同?本轮另外保留了每个进程最初的 21 批耗时:
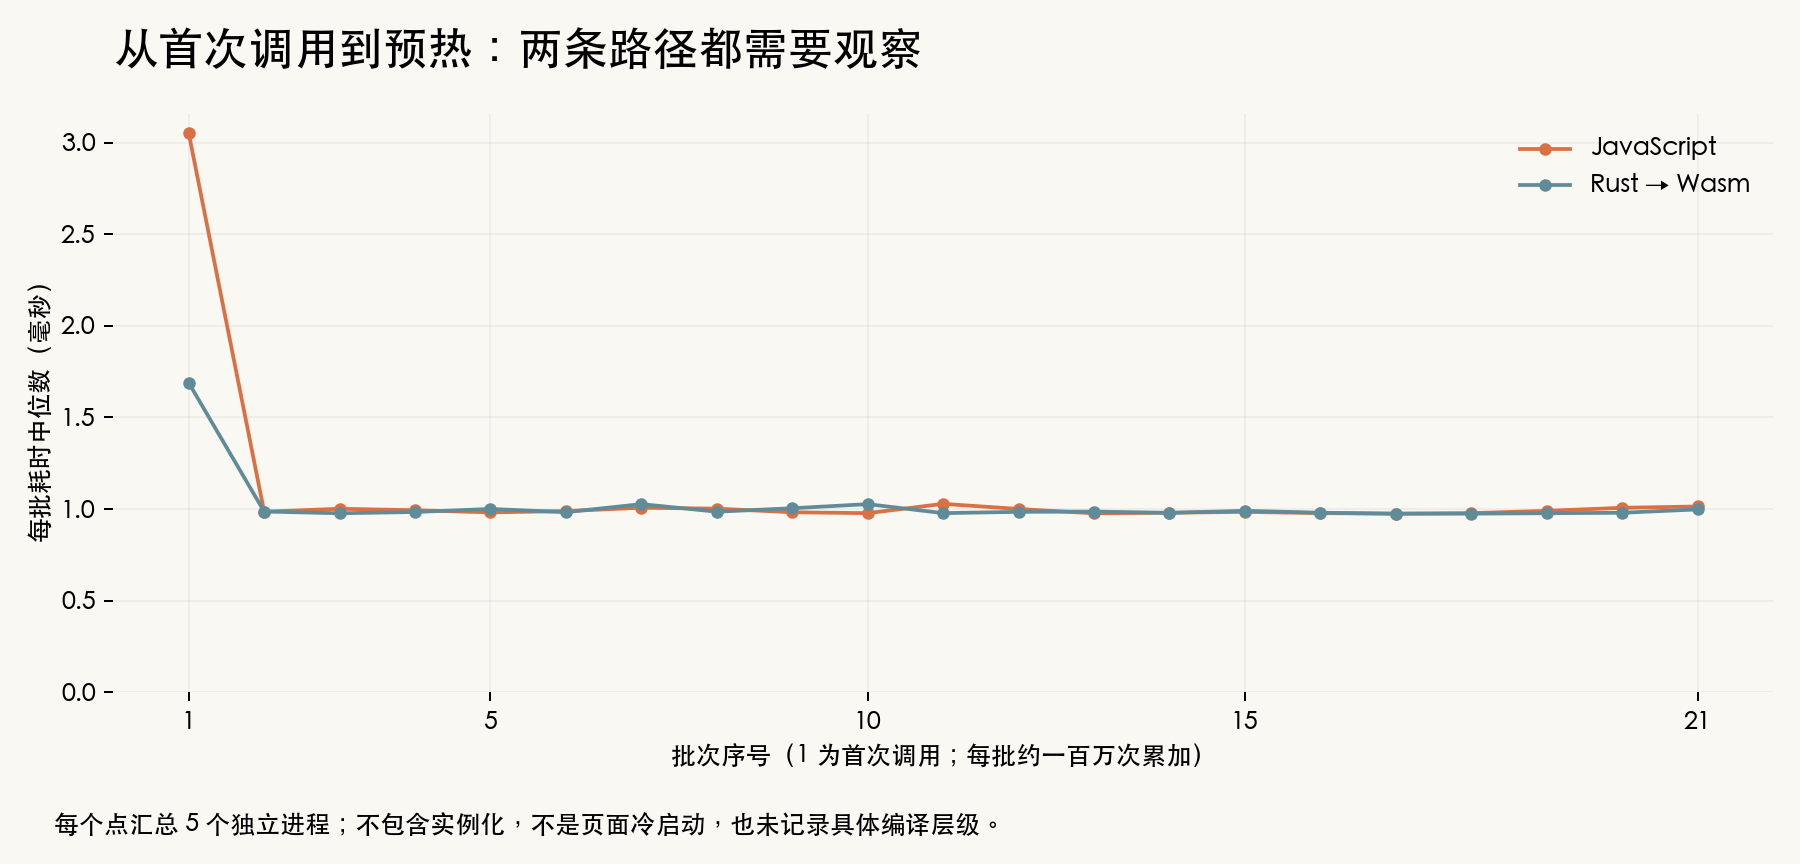
| 实现 | 首批耗时中位数 | 第二批耗时中位数 | 预热后汇总值 |
|---|---|---|---|
| JavaScript | 3.052 ms | 0.986 ms | 0.995 ms |
| Rust → Wasm | 1.689 ms | 0.987 ms | 0.980 ms |
两条路径的首批都较慢,之后迅速接近。这条曲线没有包含模块实例化和网络下载,也没有记录每一刻的编译层级;编译、缓存和调度都可能参与其中。因此它是观察轨迹,不是“第二批一定已经完成最高层优化”的证据,更不是整个页面的冷启动时间。
一批本身就包含约一百万次累加,JS 在首次调用期间也可能发生编译层级切换。因此,首批耗时不能视作纯解释执行耗时,第一批与第二批也不能直接当作解释器和 JIT 的对照。
为了进一步验证执行配置的影响,再运行相同的 JS 数值循环,只给 Node.js 增加 --jitless:
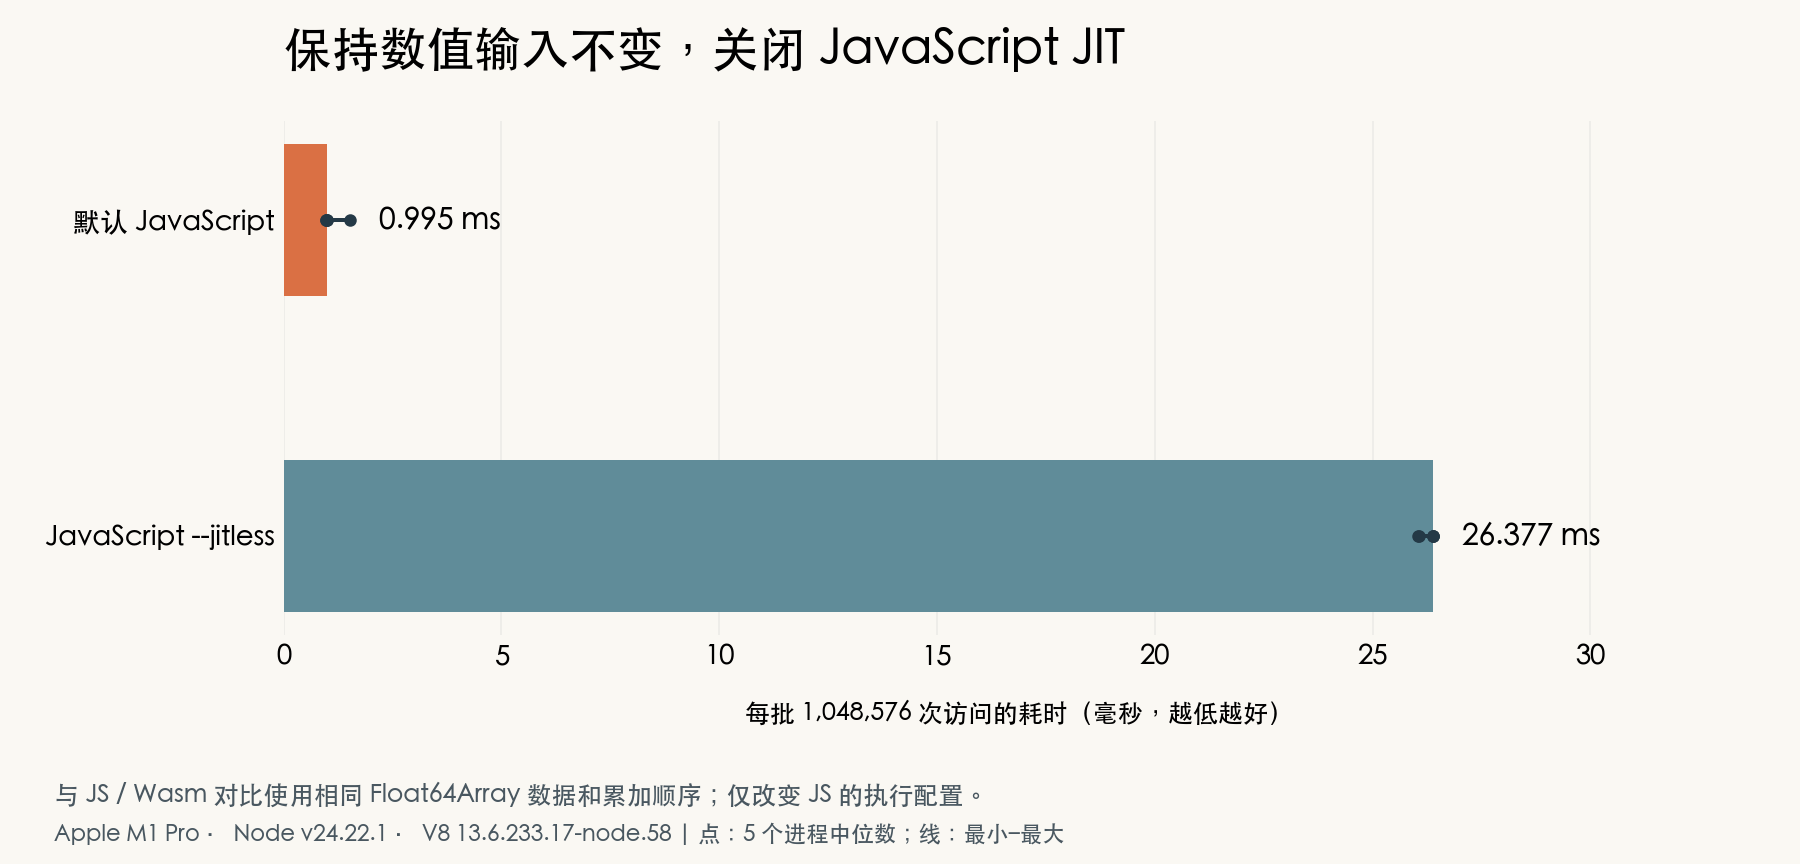
| JS 执行配置 | 每批耗时 | 相对默认执行 |
|---|---|---|
| 默认配置 | 0.995 ms | 1.00 倍 |
--jitless | 26.377 ms | 26.51 倍 |
这比“JS 本来就很快”更具体:在相同输入和相同循环下,允许 JIT 的配置与禁止运行时生成可执行代码的配置,出现了明显差距。 --jitless 仍然保留解释器及原生实现的内建功能,不是完全无优化,也不能用它的 26.51 倍差距推算单次去优化的成本。见 JIT-less V8。
我们已经看到一段稳定数值循环的表现。接下来改变 JS 的容器和对象布局,观察这些变化如何影响读取与求和的耗时。后续实验只比较不同 JS 输入,不再与 Wasm 对照,因此不能直接用来确定 JS 接近 Wasm 的必要前提。
第三步:换成普通数组,性能会掉下去吗
前面的 JS / Wasm 比较选择了 Float64Array,让双方都处理明确的双精度数据。下一步自然要问:如果 JS 改用普通数组,耗时会明显增加吗?
下面是一组单独采集的对照,保持数值和循环完全相同,只改变容器构造方式;不要把它和前一轮的小数点后差异拼成跨批次排名:
const SIZE = 32768;

// 案例一:逐项 push,形成连续的普通数组。
const packed = [];
for (let i = 0; i < SIZE; i++) packed.push((i % 100) + 0.25);

// 案例二:先创建指定长度,再逐项赋值;计时前已没有缺失项。
const preallocated = new Array(SIZE);
for (let i = 0; i < SIZE; i++) preallocated[i] = (i % 100) + 0.25;

// 案例三:使用明确的 64 位浮点存储格式。
const typed = new Float64Array(SIZE);
for (let i = 0; i < SIZE; i++) typed[i] = (i % 100) + 0.25;
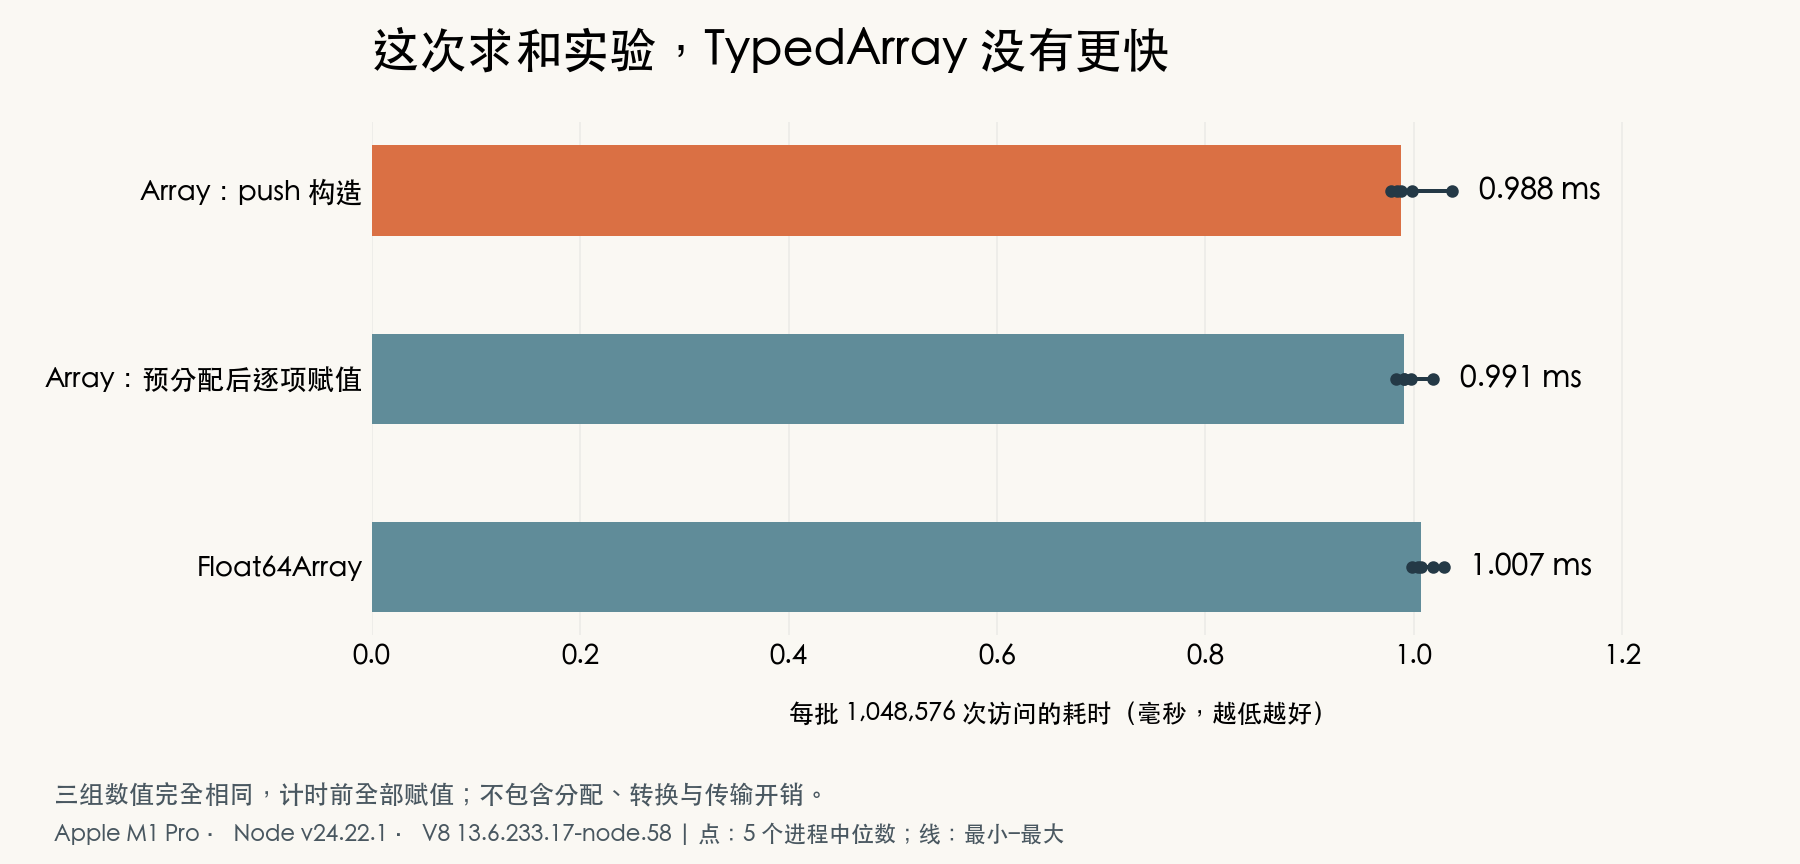
| 容器 | 每批耗时 | 相对 push 数组 |
|---|---|---|
| 普通数组,push 构造 | 0.988 ms | 1.00 倍 |
| 普通数组,预分配后逐项赋值 | 0.991 ms | 1.003 倍 |
| Float64Array | 1.007 ms | 1.019 倍 |
这些差异很小,进程中位数范围也有重叠,无法据此宣称一个容器稳定优于另一个。
独立诊断显示,前两者在本次 V8 中分别为 packed double 和 holey double;虽然第二组的每个索引都已赋值,其内部元素种类仍然带有 holey 标记。Float64Array 使用单独的元素种类,诊断中 HasDoubleElements=false 不表示它没有存浮点数。
Holey、真正存在缺失元素、字典存储是不同概念。普通数值数组也可以使用专门的 double 存储,不应把它描述为“每个值必然都是独立堆对象”。V8 官方还明确提醒,普通应用中的 packed/holey 差别往往很小;其文档在 2025 年补充了 Array.prototype.fill 的特例,因此“holey 永远不能恢复”也不能当作绝对规则。见 Elements kinds in V8。
TypedArray 的理由可以是需要明确的数值表示或二进制接口,而不是它的名字里有 Typed 就一定更快。这一组容器对照只测读取求和,没有测创建、格式转换、传输、SIMD 或 Wasm 交互。
第四步:从数值进入对象,差距开始在哪里出现
实际业务更常见的是订单、用户和坐标对象,而不是纯数值缓冲区。现在把读取 data[i] 改成读取 data[i].x:运行时需要知道对象里的 x 在哪里。
这一组比较 1、4、16 种对象形状。所有对象都只有 x、a、b、c 四个字段,数值相同,区别仅在字段插入顺序。多个布局按固定周期交替出现。
具体构造中,1 种和 4 种形状组都首先插入 x,16 种形状组还包含在其他位置插入 x 的排列。因此,这组实验同时涉及 Map 数量和字段布局的变化,没有把 Map 数量单独隔离为唯一变量。
核心计算如下,完整版本在随文脚本中:
// 每批工作量固定;对象构造发生在计时之前。
const PASSES = 32;

function sumObjects(data) {
  let total = 0;
  for (let p = 0; p < PASSES; p++) {
    for (let i = 0; i < data.length; i++) {
      total += data[i].x;
    }
  }
  return total;
}
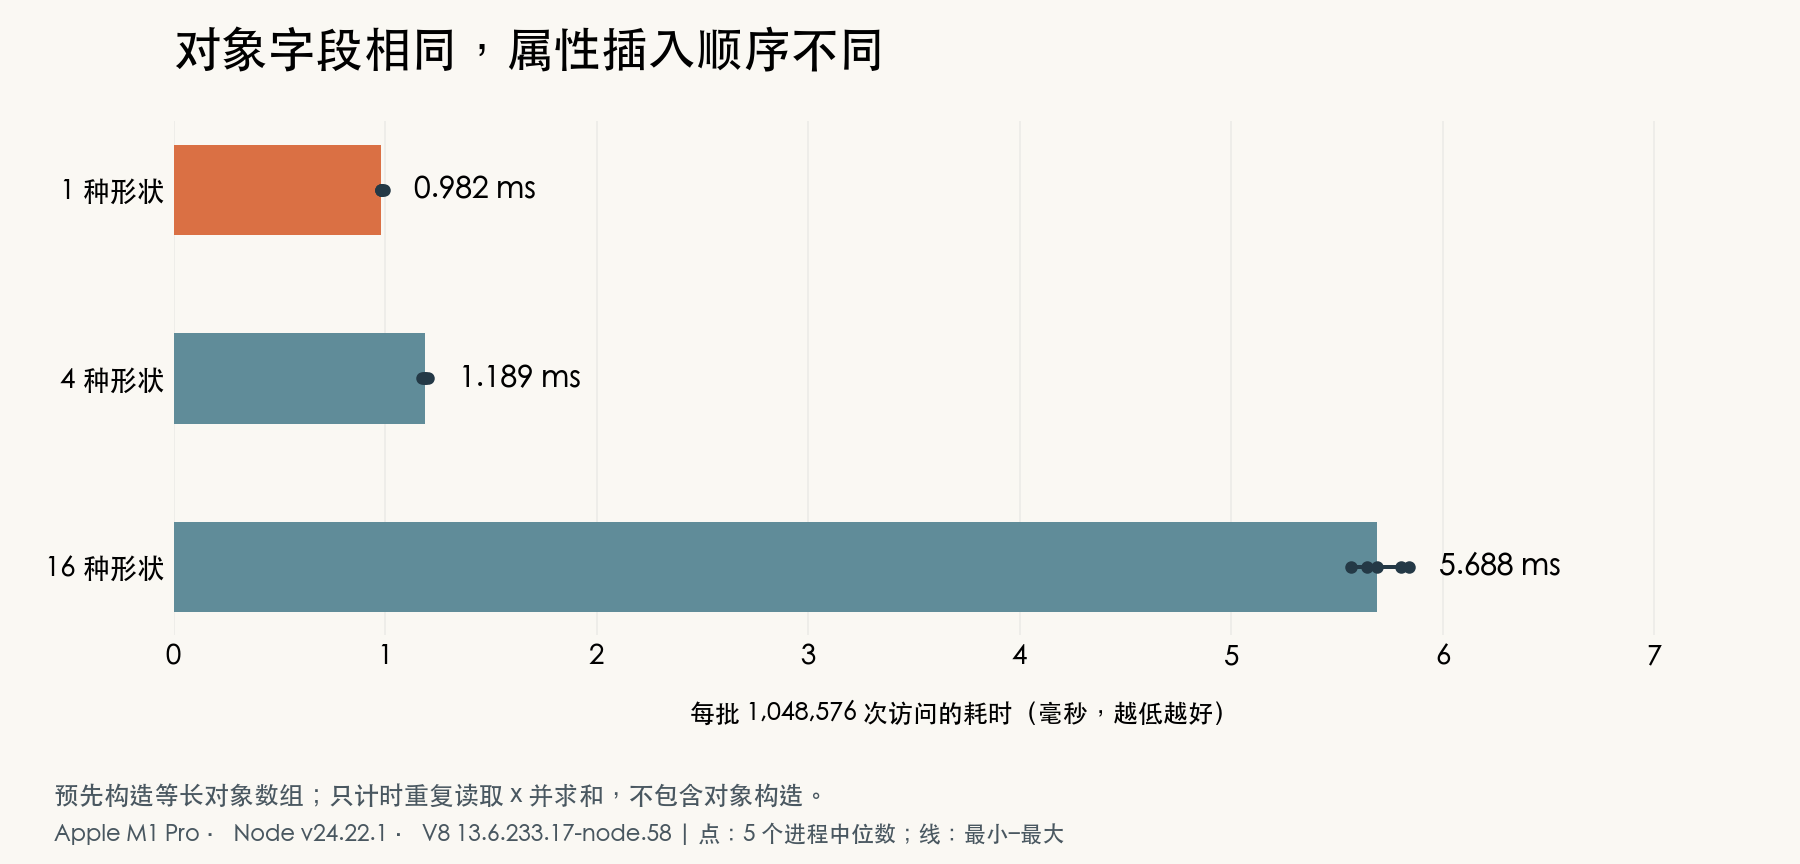
| 输入布局 | 每批耗时 | 相对单一形状 |
|---|---|---|
| 1 种形状 | 0.982 ms | 1.00 倍 |
| 4 种形状 | 1.189 ms | 1.21 倍 |
| 16 种形状 | 5.688 ms | 5.79 倍 |
独立诊断通过 V8 内部函数确认:样本确实具有 1、4、16 个不同 Map,并且仍使用快速属性,而非字典属性。计时测到的是整个循环,因此不能把全部差距直接等同于“IC 查找多花了多少时间”;字段偏移、生成代码和内存访问也参与其中。这里没有直接采集 IC 状态。
对业务代码,更实用的做法是在明确的数据边界整理结构。例如订单来自不同接口时,先转换为内部计算模型,再批量处理:
/** 计算使用的内部模型;字段顺序由统一工厂确定。 */
type LineItem = {
  /** 商品标识,用于关联业务记录。 */
  sku: string;
  /** 已通过业务校验的数量。 */
  quantity: number;
  /** 已转换为同一币种最小单位的单价。 */
  unitPriceCents: number;
};

/** 调用方需先校验外部数据;类型标注本身不执行运行时校验。 */
function createLineItem(
  sku: string,
  quantity: number,
  unitPriceCents: number,
): LineItem {
  return { sku, quantity, unitPriceCents };
}
这个例子表达结构约定,不承诺一定加速。复制对象的成本应计入业务整体耗时;只读取一次的小对象,通常不值得为了形状额外复制。
也不要机械地把缺失字段补成 null:Object.hasOwn、序列化和业务判断都可能因此改变。先确定语义,再讨论布局。
对象形状与 IC:理解这组差异的机制背景
以下介绍可能参与这一差异的机制,不是对本次耗时差距的直接归因。
考虑这个函数:
function getX(point) {
  return point.x;
}
这处 point.x 可以接收不同对象。V8 用 Map,也常称隐藏类,描述对象布局;内联缓存(Inline Cache,IC)记录某个访问位置遇到的 Map 及对应的访问处理方式。命中后,可以沿已知路径读取属性,减少重复查找。
这里有三个容易混淆的地方:
- IC 不是函数内联。函数内联是把被调用函数的逻辑放入调用者;IC 是缓存动态操作的处理方式,两者可以配合。
- 单态、多态描述的是一个访问位置观察到的情况,而不是整个项目有多少种对象。
- 形状变多不等于缓存全部失效。多态访问可以有多个快速分支;超多态也可能使用共享缓存,而不是每次都从头查找。
实现细节会随 V8 版本改变,不应把“超过四种就一定慢”写成语言规则。详见 V8 的 Hidden Classes and Inline Caches 文档。
形状也不只是“有哪些属性”。属性添加顺序会影响 Map 的演化路径。下面两个对象都有 x 和 y,构造过程却不同:
const first = {};
first.x = 1;
first.y = 2;

const second = {};
second.y = 2;
second.x = 1;
动态添加属性本身不是错误:如果对象沿相同顺序构造,仍然可以共享 Map。真正值得关注的是热点位置接收到的布局是否稳定,而不是看到赋值语句就改成对象字面量。背景见 Fast properties in V8。
第五步:当已经成立的假设突然改变
前面的对象实验比较的是预热后持续使用某类输入的耗时。还有另一种情况:一个函数已经针对旧输入完成优化,这时突然遇到新的输入,会发生什么?
下面这个函数确实可能因输入类型变化而去优化:
function addNumbers(a, b) {
  return a + b;
}

addNumbers(1, 2);   // 数值加法,结果为 3。
addNumbers('1', 2); // 字符串拼接,结果为 '12'。
但仅调用这两次,并不能证明发生了去优化:函数可能还没被优化过,或者已有实现能够处理这些输入。
为观察机制,随文诊断脚本先用数值建立反馈,再通过 V8 内部函数显式请求优化,最后传入字符串。在本机日志中,addNumbers 先完成 TURBOFAN_JS 编译,随后出现:
before changed input
[bailout (kind: deopt-eager, reason: not a Smi): ... JSFunction addNumbers ...]
after changed input: result=12 (string)
这是节选,省略了地址等字段,完整记录随文保留。Smi 是 V8 的一种小整数表示。
这个受控例子证明了“特定优化假设失效可以触发去优化”,不证明自然运行时第几次调用会触发,也没有测量其延迟。去优化需要恢复符合 JavaScript 语义的执行状态,并不意味着整个函数从头重跑,更不能仅凭一条日志断言用户发生了卡顿。
因此不把数值加法和字符串拼接放进同一张性能排名图:它们完成的工作已经不同。实际应用应先在输入边界明确业务数据类型,再检查热点中的异常类型来自哪里。
三条容易写过头的优化建议
“TypeScript 的 number 会让运行时只接收数字。” 类型标注会被擦除,接口响应、JSON 或不受检查的调用仍可能带入其他类型。内部签名表达约定,外部数据则需要真正的校验。见 TypeScript 官方 FAQ:类型擦除。
“有 try…catch 的函数不能被优化。” 这与 V8 早期 Crankshaft 的限制有关,不能套用到现代 TurboFan。把 JSON.parse 包进一个新函数,也不能保证改变优化结果。应按错误处理职责组织代码,实际抛异常的成本另行测量。见 Launching Ignition and TurboFan。
“只有 JIT 能利用运行数据,静态编译做不到。” AOT 工具链同样可以使用 PGO,读取采集到的运行剖面;LLVM 就提供了这样的工作流。区别在采集、反馈和编译发生的时间,而不是静态编译完全看不到真实负载。见 LLVM 的 PGO 指南。
逃逸分析与标量替换也不应简单归因于“JIT 观察到对象没有逃逸”:优化器还需要程序分析来证明变换安全。本次没有为这一点设计实验,不把“创建临时对象”自动当成分配已消除的证据。
怎样把实验转化为工程判断
现在可以回到开头的问题:JavaScript 的热点数值代码有机会在 JIT 优化后接近 Rust → Wasm,但相近的局部耗时既不说明语言等价,也不保证把真实程序换一种语言就会更快。
评估 Wasm 时,至少要分开考虑计算内核、数据表示与复制、调用粒度、模块加载和预热。本文只测一个串行浮点求和内核,以及每批复制一次的变体;没有覆盖图像处理、压缩、SIMD、多线程或完整应用。
对于已经确认的计算热点,可以检查:同一个访问位置是否混入不必要的布局差异?数据边界是否足够明确?是否因为删除元素或越界读写制造了额外情况?改变容器之后,转换与分配成本是否反而增加?
如果慢的是网络、数据库、重复渲染或算法复杂度,应先处理这些问题。即使某个局部循环变快五倍,只占总时间的一小部分,也不会让整个请求变快五倍。
本文最值得保留的不是一张“高性能写法清单”,而是验证顺序:先保证语义相同,再隔离变量测量;用诊断解释现象,最后回到真实负载验证收益。
复现实验与原始数据
可以直接下载本次实验的源码与原始数据包。下载包固定于提交 96125041ccb9dab4fec8a5a4b1be60505ce7c487,包含基准、诊断、绘图脚本、Rust 内核、Wasm 二进制及原始结果,并保留脚本所需的目录结构。
解压后,在解压目录根目录运行以下命令;需要预先安装 Node.js、Rust 工具链,以及用于绘图的 Python 和 Matplotlib。实验版本见文首环境表,脚本使用中文说明关键约束:
# 首次运行 Rust / Wasm 对照前安装编译目标。
rustup target add wasm32-unknown-unknown

# 优化编译 Rust,校验输出,再运行 JS / Wasm 对照。
node scripts/benchmarks/js-jit/wasm.cjs

# 运行对象与数组对照;覆盖解压目录中的结果,不保证复现相同数值。
node scripts/benchmarks/js-jit/benchmark.cjs

# 独立机制诊断,不参与计时;这些内部 API 可能随 V8 版本变化。
node --allow-natives-syntax --trace-opt --trace-deopt \
  scripts/benchmarks/js-jit/diagnose.cjs \
  > public/experiments/js-jit/diagnostics.txt

# 绘图需 Python 与 Matplotlib,输出 PNG 和 SVG;本机使用 macOS 黑体。
python3 scripts/benchmarks/js-jit/render.py
下载 JS / Wasm 计时数据 · 下载对象与数组计时数据 · 查看完整诊断日志
复现时建议关注三个问题:结果是否足以支持优化结论;修改是否保留了原有语义;哪些局部观察仍需要在目标引擎、版本与真实业务中重新验证。